fonte certa com a pessoa certa na hora certa
o que os dados da atlantico mostram sobre onde a ia realmente entrega valor no brasil
há alguns anos acompanho o latin america digital report da atlantico, que consolida dados e análises sobre a economia digital de latam. é o tipo de material que me ajuda a separar o que de fato mudou do que só parece novo.
pra quem ainda não conhece: a atlantico é um VC early-stage, com base em são paulo, que investe em empresas “pré-scale” com sinais iniciais de product-market fit. a tese é explícita: “we back bold founders seeking to define a better future in latin america and beyond”, com um time formado por founders/operators e foco de apoio operacional ao portfólio.
a edição de 2025 do report (“the end of friction: latin america at an inflection point”) foi ao ar hoje e quero trazer alguns insights pra vocês.
foquei nos slides que falam de
adoção de AI
confiança do usuário/cliente
hábito de uso digital no brasil e méxico.
três coisas que impactam diretamente quem trabalha com mercado financeiro, relacionamento e produto.
o ponto de partida é simples: quando existe dado interno bem organizado e critério claro de qualidade, a AI anda. engenharia, conteúdo, produto e acervo encontrável mostram isso. quando entram processo, gente e reputação (vendas, atendimento, RH), a régua muda por um motivo bom: responsabilidade.
tem também a camada que costura tudo: confiança. as pessoas preferem conversar com gente e compartilham dados com quem já faz a gestão do dinheiro delas.
e tem o hábito. penetração alta não vira rotina sozinha. o brasil é do mobile: whatsapp e voz puxam a atenção, mas em segundos sua mensagem pode ser abandonada.
a pergunta deixa de ser “funciona?” e vira “chega a tempo e no lugar certo?”.
a partir desse recorte, a ideia é prática: usar os gráficos apresentados para tomada de decisão em distribuição. mais organização, fonte clara, resposta no tempo certo com humano assinando a versão final. é daí que vem resultado.
adoção que gera efeito
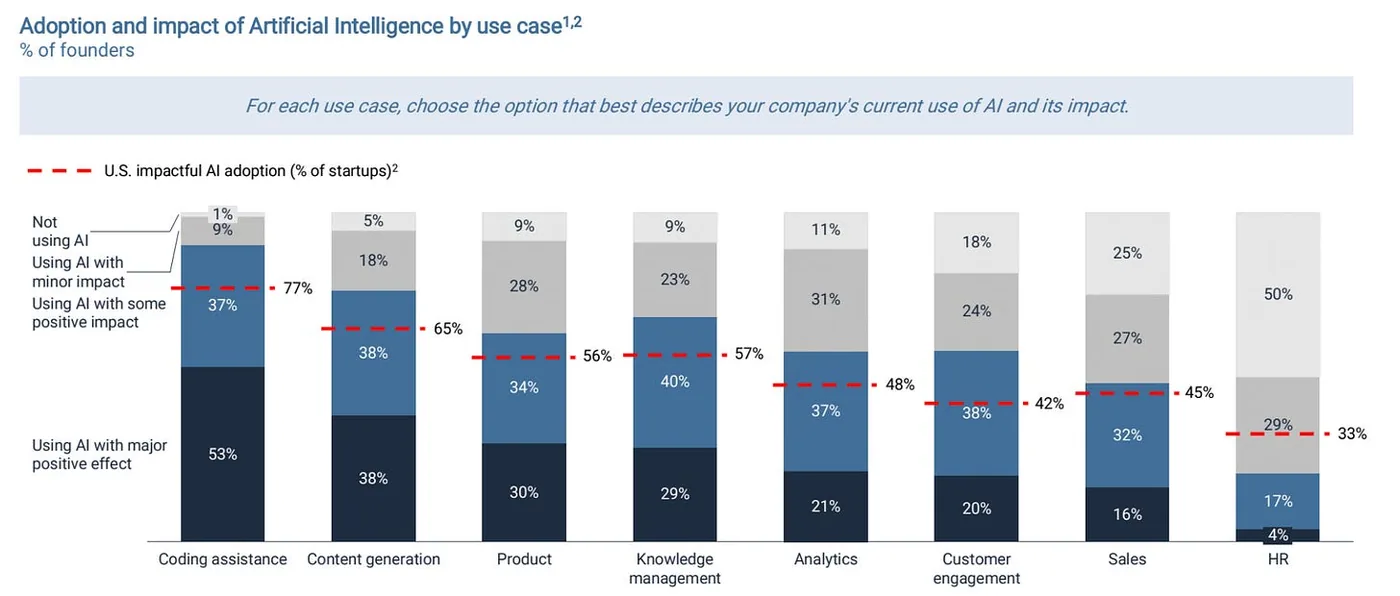
o gráfico de “impacto por caso de uso” só confirma o que a operação já sabe: onde a base de dados é bem definida e a análise tem critério objetivo, a AI paga a própria conta.
em engenharia o jogo é binário e curto. a máquina acerta ou quebra. assistentes de código tiram casca de tarefa repetitiva, sugerem testes, apontam regressão. o efeito não vem do “código pronto”, mas do encurtamento de ciclos.
em conteúdo a vantagem está no entorno do processo. pesquisa vira repertório, rascunho sai mais rápido e a padronização de tom e de referências deixa de drenar energia. sobra foco para o que não dá para terceirizar: voz e tese. o resultado aparece na conversão do mesmo material em múltiplos formatos, cada um adaptado com o discurso certo.
em produto (o que seria gestão no nosso mercado) a fricção cai entre problema → hipótese → entrega. especificações chegam mais claras porque a AI preenche o que é repetível, testes ganham cobertura e o backlog rende sem pular passo. isso corta retrabalho e encurta ida e volta com o usuário.
e nada disso se sustenta sem investir em conhecimento. é aqui que a curva dobra. boa taxonomia, fontes confiáveis, versionamento e rastro do que foi usado reduz o custo considerável de “onde está o que preciso?”. quando buscar “alocador x / reunião q2” devolve o racional certo, com slides, e-mails e objeções linkadas. o resto flui.
o impacto aparece em três momentos:
antes da reunião, em dois cliques, você recupera o último racional que usou com aquela conta, as dúvidas que ficaram e os argumentos que basearam a resposta.
durante, a assistência puxa trechos do seu próprio acervo, mostra a fonte e oferece dois caminhos plausíveis de avanço. você escolhe, ajusta uma linha e segue.
depois, o registro sai do improviso: o resumo da call cai no CRM com link para as evidências e o follow já vem rascunhado no tom da casa.
quando o dado existe e está no lugar certo, o relacionamento melhora sozinho. quando não está, qualquer teste de implementação de AI só cria mais trabalho.
a métrica que vale, no fim, é se o ciclo encurtou sem perder responsabilidade: menos tempo para achar, menos tempo para responder, menos retrabalho depois. é isso que “impacto por caso de uso” quer dizer aqui — e é por isso que começa no backstage.
confiança não é slogan
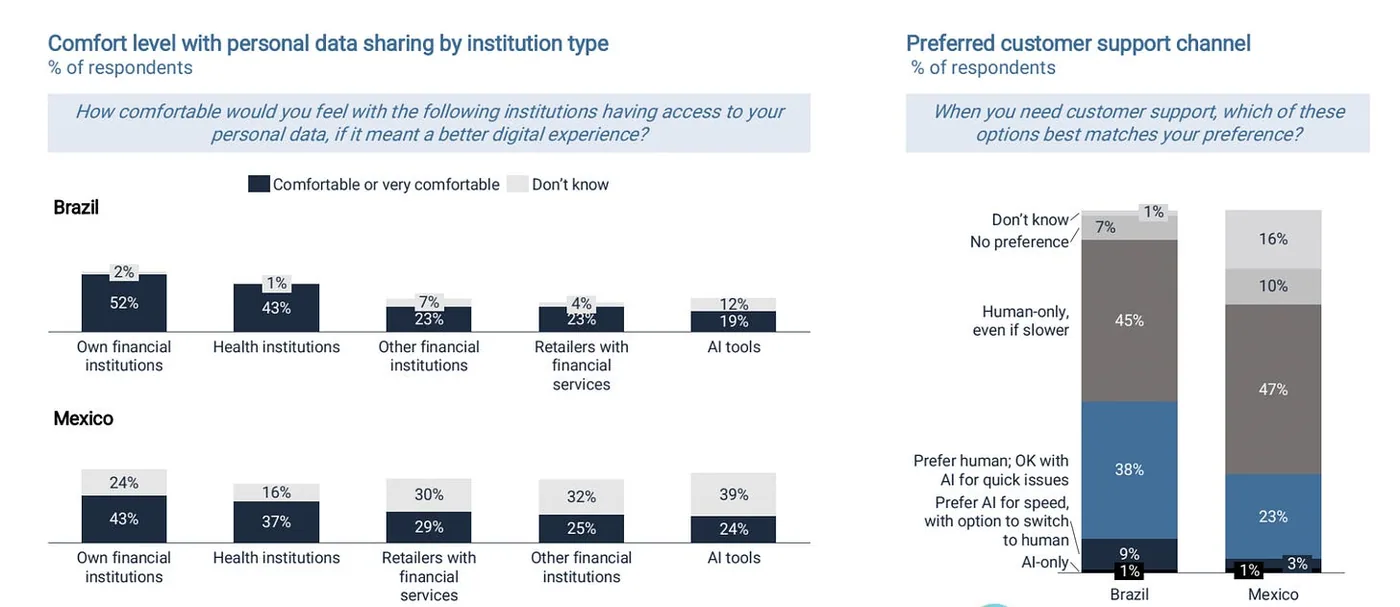
os gráficos colocam um limite prático: as pessoas preferem falar com gente e só se sentem confortáveis em dividir dados quando a conversa acontece dentro de quem já guarda o dinheiro delas.
“ferramenta de AI” como categoria abstrata não tem essa licença social. no méxico há um pouco mais de tolerância ao híbrido; no brasil, a régua é mais conservadora. isso não é um problema de tecnologia — é de confiança.
o lugar certo da AI, portanto, é dentro do canal incumbente, com o mesmo login, a mesma política de privacidade e a mesma responsabilidade. nada de app paralelo pedindo cadastro nem de domínio estranho.
a experiência é a de sempre, só que com um motor melhor. quando o alocador abre o chat da gestora e pergunta algo sobre produto ou governança, quem aparece é o time de RI — e, por trás, o sistema já puxou o parágrafo correto do documento, recuperou o histórico daquela conta e montou duas versões de resposta consistentes. o humano lê, ajusta uma linha e envia.
parece de outro mundo, né?
não só é possível como já existem players do mercado brasileiro fazendo.
essa estrutura tem alguns princípios simples.
fonte sempre visível, dentro da própria resposta.
uma frase curta de explicação do histórico: o documento usado, a data, o trecho.
segregação por cliente e por função, para que um atendente só veja o que precisa ver.
modelos que não são treinados em cima de conteúdo sensível.
dados que ficam no país quando a regulação exige.
tudo isso de forma explícita.
o tom também é parte da confiança. a resposta não precisa soar “robótica” só porque foi assistida. ela precisa soar como a sua equipe escreve: precisa no vocabulário, com contexto e cuidado com as sutilezas do mandato. por isso o humano assina a versão final.
a AI prepara, organiza, adianta, mas não substitui a decisão nem a responsabilidade. humano responde, com informações alinhadas, no canal certo.
quando essa base está montada, muda a forma de medir. deixa de ser “qual a conversão de AI?” e se torna:
“em quanto tempo a primeira resposta útil chegou?”
“quantas conversas foram resolvidas no primeiro contato?”
“quantas respostas saíram sem retrabalho?”
“quantos incidentes de dado tivemos?” (a meta aqui é zero).
no méxico dá para testar passos mais ousados no front; no brasil, o desenho começa pelo humano no circuito e evolui conforme a confiança se prova no cotidiano.
os erros que quebram essa lógica são sempre parecidos:
bot como porteiro bloqueando o caminho
resposta sem fonte que vira opinião
relação fria com o cliente sem contexto do que já foi feito
tom desalinhado com a marca. cada
uma dessas coisas fere a tal “licença social”. e, quando ela racha, todo o ganho de “produtividade” evapora.
no fim, confiança não nasce de uma frase no seu site. nasce do jeito como a operação guarda, explica e registra cada interação. se a AI respeita isso, ela acelera a relação em vez de ameaçá-la.
do tendência ao hábito
penetração alta não vira rotina por osmose. no celular, a janela de atenção é curta e o contexto é fragmentado. hábito nasce quando a AI entra na tarefa no exato minuto em que ela aconteceria e responde rápido o bastante para não quebrar o fluxo.
isso implica preparar a resposta antes do clique:
às 8h55, o sistema já deixou prontos os pacotes das três reuniões da manhã. quando você abre, não “gera”, só entrega.
segunda de manhã chega o pipeline com três coisas que importam: qual contato avança hoje, qual foi o último racional usado e quais objeções ficaram em aberto.
quarta, meia hora antes das calls, cai no whatsapp um resumo de cada conta com o histórico essencial e dois caminhos plausíveis de próximo passo.
sexta, fim do dia, chegam os rascunhos de follow com base no que mudou durante a semana.
a regra é simples: a ia resolve 85–90% do texto e deixa os 10–15% finais para o humano assinar, com as fontes à vista.
voz encurta o trajeto. você grava 20 segundos (“preciso de um e-mail de follow para o alocador x, lembrando a política de risco e anexando o slide de julho”). em menos de um suspiro, volta um áudio de 30 segundos com o rascunho lido e o texto pronto no app de e-mail, já linkado às páginas internas que sustentam a resposta. um “aprovar” por voz envia e registra. se quiser, você pede “explica de onde veio” e ouve os trechos da fonte, sem abrir uma aba.
latência, nesse caso, é métrica de negócio. se a resposta completa não chega em tempo, a tecnologia precisa degradar com elegância: primeiro entrega um resumo curto e, depois, em segundos, substitui pelo detalhado com citação de fonte.
o usuário não fica esperando; ele decide com o que tem e, se precisar, aprofunda quando a versão final pousar. sem telas intermediárias, sem pedir login extra, sem empurrar para um “ambiente novo”.
medir hábito é parar de contar cliques e começar a medir tempo até a primeira resposta útil, repetição semanal dos mesmos fluxos (pipeline, call, follow), avanço de estágio por resposta enviada e abandono por espera. quando essas curvas se mexem, significa rotina consolidando comportamento.
há algumas regras que incentivam (e protegem) o hábito:
nenhuma captura de voz deve guardar o áudio bruto além do necessário.
o texto derivado é o que fica, com retenção definida.
dados sensíveis precisam de mascaramento automático quando a conversa transita por canais de terceiros.
toda interação gera trilha: quem pediu, o que foi consultado, quem aprovou.
isso evita o “efeito bot porteiro” e mantém a confiança operando enquanto o ganho de tempo aparece.
se a resposta chega no tempo certo e com a responsabilidade no lugar certo, vira rotina. se pede um passo a mais, morre.
precisão, custo e privacidade: a ordem certa
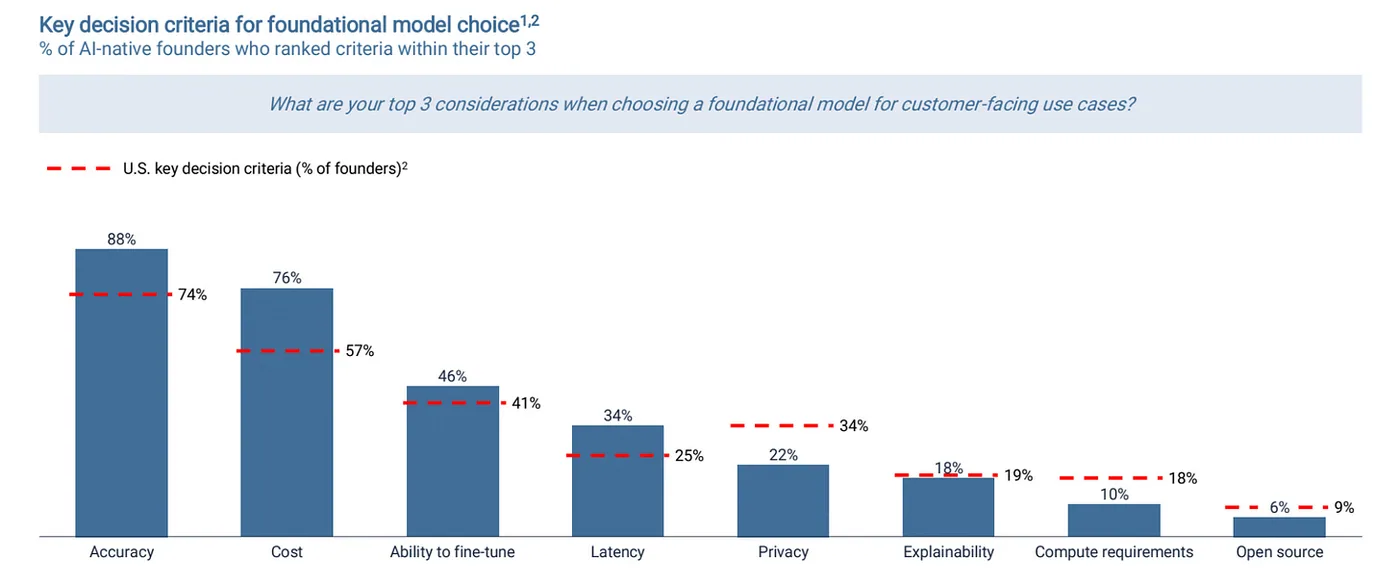
o gráfico mostra founders priorizando precisão e custo, com privacidade no rodapé. faz sentido para quem corre atrás de tração. mas no mercado financeiro a conta inverte: privacidade não é etapa, é pré-requisito. sem isso, nada escala.
o caminho prático começa antes do modelo: classificar o que é sensível, separar o que pode sair do perímetro, definir retenção e rastreio. só depois vem a escolha técnica.
precisão é efeito de três coisas em conjunto:
acervo interno organizado
política de fonte (o que pode ser usado, em qual ordem)
avaliação contínua
não é “pegar um modelo melhor”. é desenhar o funil de resposta: buscar no seu próprio corpus com critérios, montar síntese com citações explícitas, bloquear inventário fora de política. quando isso está no lugar, o ROI aparece naturalmente porque você usa modelos mais leves para o que é repetível e guarda os pesados para o que exige complexidade.
custo, tratado com seriedade, não é “baratear inferência”. é escolher o certo para cada tarefa.
tarefas de estrutura (classificar, extrair, padronizar) rodam bem em modelos abertos/locais, com latência baixa e previsibilidade.
tarefas que tocam contexto sensível ou linguagem de marca ficam em provedores com garantias de não-treinamento e residência regional.
o mix reduz a fatura e mantém a régua de qualidade onde importa. parece detalhe técnico, mas vira margem.
traduzindo para o dia a dia:
uma pergunta sobre o fundo não vai “ao modelo” cru. ela passa por um roteador que puxa o documento certo, monta duas versões de resposta com citação de fonte e exibe a retenção daquela peça. o atendente ajusta uma linha e envia.
uma dúvida de carteira não vaza para fora do perímetro. roda em base anonimizada, com simulações precomputadas, e volta com texto no tom da casa. tudo com rastro.
nesse arranjo, precisão, custo e privacidade deixam de competir. cada uma ocupa seu lugar — e o resultado é um sistema que anda rápido sem aumentar risco.
confiança como base
no fim, esses gráficos contam uma história simples: a AI que interessa não é o app da moda. quando você trata confiança como base, o resto se encaixa: dado próprio bem organizado, regra clara de uso, humano assinando a decisão.
o resultado aparece onde importa: menos tempo para achar o que precisa, menos idas e voltas, mais conversas que avançam.
o primeiro movimento é arrumar a casa. não tem glamour.
escolha um pedaço do acervo de materiais que você usa no seu dia a dia (apresentações, minutas, políticas, atas).
dê nome, versão e fonte.
faça a busca devolver o trecho certo com um clique e deixe registrado o que foi usado.
mude também o jeito de medir. pare de contar aberturas de email ou agendamento de calls.
acompanhe tempo até a primeira resposta útil
avanço de estágio depois dessa resposta
retrabalho evitado
se isso avança, o processo está funcionando.
fazer o feijão com arroz continua sendo o segredo. o que mudou é o tipo de ferramenta.
insights sobre marketing, tecnologia, negócios e o tendências no mercado financeiro.
assinar a carta